Nr. 4 (2026)
DOI: 10.5282/o-bib/6330
An der Pädagogischen Hochschule Freiburg erhalten die meisten Studierenden zu Beginn ihres Studiums im Rahmen einer Bibliothekseinführung eine 45-minütige Einführung in die Literaturrecherche. Vermittelt werden die Grundlagen, z. B. Medienkunde und Bedienwissen, keine vertieften Recherche- strategien. Ein Teil der Studierenden erhält später eine ausführlichere Rechercheschulung auf Anfrage der Dozierenden von etwa 90 Minuten. Versuche, zusätzliche Veranstaltungen verbindlicher in die Curricula zu integrieren oder mehr Veranstaltungszeit zu erhalten, waren bislang nur begrenzt erfolgreich.
Die verfügbaren Veranstaltungsstatistiken reichen bis 2012 zurück. Bereits seit diesem Zeitpunkt zeigt sich, dass freiwillige, nicht in Lehrveranstaltungen eingebundene Rechercheveranstaltungen häufig nur schwach nachgefragt werden oder ganz ausfallen. Dieser Trend hat sich über die Jahre fortgesetzt. Entsprechende offene Angebote wurden daher zunehmend reduziert; stattdessen wurde der Schwerpunkt stärker auf Rechercheveranstaltungen gelegt, die in Lehrveranstaltungen eingebunden und gemeinsam mit Dozierenden organisiert werden. Für die vertiefte Vermittlung von Recherchekompetenz bleiben damit in der Regel 90 Minuten.
90 Minuten für die vertieften Rechercheschulungen klingen zunächst nicht schlecht, bis man zusammenstellt, was darin sinnvollerweise vorkommen sollte, welches Wissen, welche Haltungen, welche Kompetenzen notwendig sind. Übungsphasen und Ergebnissicherung sind dabei essenziell, damit das Vermittelte auch langfristig anwendbar bleibt. Je nach Semester, in dem die Studierenden an der Veranstaltung teilnehmen, steht die Bachelorarbeit jedoch erst drei Semester oder gar später an. Würden Sie sich noch an Trunkierung oder die „Datenbank von damals“ erinnern?
Inzwischen kommt eine weitere Anforderung hinzu. Dozierende und Studierende möchten wissen, welche Rolle Sprachmodelle und andere KI-basierte Systeme bei der Literaturrecherche spielen können. Auch wünschen sich Dozierende zunehmend, dass das Thema „Informationen bewerten“, auch als Reaktion auf KI, stärker berücksichtigt wird. Was streicht man hierfür aus der Schulung? Häufig lautet die Antwort: Inhalte werden weiter verkürzt und komprimiert, eine weitere Übung entfällt. Damit entsteht ein Veranstaltungskonzept, das formal sehr viel vermittelt und dabei doch wenig bewirkt.
Aus Sicht der Studierenden steht diesem komplexen Angebot inzwischen eine ausgesprochen attraktive Alternative gegenüber: Sprachmodelle ermöglichen einen unmittelbaren Einstieg in die Literaturrecherche, ohne dass Kenntnisse über Suchfelder, Trunkierung oder Boolesche Operatoren erforderlich sind. Das System antwortet unmittelbar. Bibliotheken konkurrieren hier deshalb nicht nur mit einer neuen Informationsquelle. Sie konkurrieren mit einer erheblich niedrigeren Bedienhürde.
Carol Kuhlthaus Modell des Information Search Process beschreibt ein Problem, das an dieser Stelle bemerkenswert aktuell wirkt. Gerade die frühen Phasen einer komplexen Recherche sind von Unsicherheit geprägt. Die eigentliche Formulierung eines Fokus entsteht erst im Verlauf der Auseinandersetzung mit einem Thema. Kuhlthau beschreibt deshalb gerade die Explorationsphase als einen Punkt, an dem Unterstützung besonders sinnvoll ist.1
In diesem Zusammenhang ist auch der kürzlich in o-bib erschienene Artikel zum Thema Bibliotheksangst relevant. Prokrastination bei der Recherche wird hier (nicht nur, aber) auch mit der „Angst vor einer zu umfangreichen oder zu niedrigen Quellenlage“ und einem Mangel an Motivation begründet.2 Bemerkenswert ist dabei, dass die untersuchten Fokusgruppen aus Studierenden der Informationswissenschaften bestanden, die Recherche im Studium bereits ausführlich behandelt hatten und überwiegend auch über praktische Erfahrungen verfügten. Wenn selbst diese vergleichsweise rechercheerfahrene Gruppe Unsicherheiten und Probleme berichtet, liegt die Annahme nahe, dass entsprechende Schwierigkeiten bei Studierenden anderer Fächer, die strukturierte Recherche häufig nur in deutlich geringerem Umfang kennenlernen, mindestens ebenso relevant sein können.
Ein weiterer möglicher Erklärungsansatz ist eine geringe Selbstwirksamkeitserwartung. Recherche ist komplex und im Studium häufig keine Routine. Gerade in einer 90-minütigen Rechercheschulung bleibt zudem nur begrenzt Zeit, das vermittelte Wissen hinreichend einzuüben. Der Begriff Selbstwirksamkeit verdient an dieser Stelle eine kurze Erläuterung. „Selbstwirksamkeitserwartung wird definiert als die subjektive Gewissheit, neue oder schwierige Anforderungssituationen auf Grund eigener Kompetenz bewältigen zu können.“3 Gerade für die Vermittlung von Informationskompetenz ist das Konzept relevant: Es lenkt den Blick darauf, wie Rechercheangebote gestaltet werden können, damit Nutzer*innen eigene Erfolgserlebnisse erfahren.
Die vorangehenden Überlegungen legen nahe: Unsicherheit ist kein Randphänomen der Recherche, sondern gerade in ihrer frühen Phase strukturell angelegt. Weitergedacht: Wenn Recherche (pars pro toto für die Bibliothek) negativ besetzt ist, dürften es auch Schulungs-, Beratungs- und Unterstützungsangebote im Speziellen und die Bibliothek (als Ort) im Allgemeinen sein. Gelingt es Bibliotheken hingegen, die Selbstwirksamkeitserwartung Studierender auch speziell bei der Recherche zu stärken, könnte dies nicht nur das wissenschaftliche Arbeiten erleichtern und Informationskompetenz langfristig steigern, sondern auch Bibliotheksangst reduzieren und allgemein bibliothekarische Dienstleistungen attraktiver machen.
Dass strukturierte KI-Unterstützung hierbei grundsätzlich einen Beitrag leisten kann, zeigt eine aktuelle Untersuchung von Hu, Hsieh und Salac: Ein KI-basiertes Learning Companion System, insbesondere in Kombination mit einem strukturierten Scaffolding, also einer schrittweisen und gezielten Unterstützung des Lernprozesses, führte bei Studienanfänger*innen zu einer höheren selbst eingeschätzten Selbstwirksamkeit im Bereich der Informationskompetenz.4
Ansätze zur Integration natürlichsprachiger Suchanfragen finden inzwischen auch Eingang in bibliothekarische Rechercheoberflächen. So bietet die Universitätsbibliothek Eichstätt-Ingolstadt in ihrem auf der bekannten Open-Source-Software VuFind basierenden Katalog eine „Smart Search“5 an, die natürlichsprachige Eingaben analysiert, Suchbegriffe erweitert und daraus eine strukturierte Suchanfrage für den Katalog erzeugt. Ein ähnlicher Ansatz wird mit dem „StabiKat Recherche-Kompass“6 der Staatsbibliothek zu Berlin verfolgt, der frei formulierte Suchanfragen in geeignete Suchanfragen für den StabiKat übersetzt. Diese Beispiele stehen exemplarisch für eine breitere Entwicklung, in deren Rahmen entsprechende Verfahren zunehmend auch von Bibliotheken selbst erprobt und in bestehende Discovery-Systeme integriert werden.
Auch kommerzielle Anbieter wie EBSCO7, Elsevier8 und Clarivate9 integrieren natürlichsprachige beziehungsweise dialogorientierte Recherchefunktionen unmittelbar in ihre etablierten Recherche- und Discovery-Systeme.
Diese Entwicklung ist grundsätzlich zu begrüßen. Zugleich sollte der Zugewinn an Komfort nicht zulasten der Nachvollziehbarkeit von Rechercheprozessen und Auswahlentscheidungen gehen. Sprache kann zweideutig sein, wissenschaftliche Terminologie variiert und Literatur wird unterschiedlich erschlossen. Wenn ein Informationssystem künftig aus einer natürlichsprachigen Frage selbstständig eine geeignete Suchsyntax erzeugt, verschwindet dieses Problem nicht. Es ist nur nicht mehr sichtbar.
Natürlichsprachige Suche löst aber eines der klassischen Probleme von Rechercheschulungen: Die Nutzer*innen müssen die Sprache eines Informationssystems nicht mehr vollständig erlernen, bevor sie eine sinnvolle Suche durchführen können und erste Erfolgserlebnisse bei der Recherche außerhalb von Chatbots erzielen. Aber sie löst nur einen Teil des Problems.
Aus Sicht der Nutzenden reduziert eine natürlichsprachige Suchfunktion zunächst die Hürde, die eigene Frage in eine für das System geeignete Form zu übersetzen. Allerdings beantwortet sie nicht die Frage: Ist dieses System der richtige Ort für meine Recherche?
Es mag trivial klingen, jedoch ist gerade die Auswahl von Recherchesystemen und Datenbanken je nach Fragestellung einer der ersten Inhalte, die häufig aus Zeitmangel gerade nicht die notwendige Aufmerksamkeit erhalten. Man verweist stattdessen auf DBIS und zeigt kurz die Oberfläche. Eine durchdachte Recherche beginnt daher mit folgenden Fragen:
Was suche ich?
Wo sollte ich danach suchen?
Wie formuliere ich meine Suche?
Die KI-getriebene Reduktion von Komplexität konzentriert sich derzeit stark auf den dritten Schritt. Die ersten beiden Schritte dagegen bleiben noch eher unberührt. Gerade hier kann KI jedoch bereits deutlich früher ansetzen.
Ausgangspunkt war die Erfahrung, dass Sprachmodelle bei der Literaturrecherche mitunter überraschend hilfreiche Unterstützung leisten können – etwa bei der Frage, wie sich eine Suchstrategie verbessern, erweitern oder präzisieren lässt. Daraus entstand die Überlegung, genau dieses Prinzip in eine strukturierte Benutzeroberfläche zu überführen und mit bibliothekarisch kuratierten Rechercheinstrumenten zu verbinden.
Technisch handelt es sich um eine an der Bibliothek der PH Freiburg entwickelte Webanwendung, die für einzelne Verarbeitungsschritte – Stichwortgenerierung, Übersetzung, Erzeugung von Query-Vorschlägen und Auswahl geeigneter Rechercheinstrumente – über eine API auf ein Sprachmodell von OpenAI zugreift. Die Anwendung verbindet diese KI-gestützte Verarbeitung mit regelbasierten Funktionen und einem von der Bibliothek kuratierten Pool von Recherchesystemen und Datenbanken. Die eigentliche Literaturrecherche findet weiterhin in den jeweiligen Zielsystemen statt. Aufgrund der positiven Rückmeldungen zum Prototyp wird der Assistent inzwischen in zwei Kontexten eingesetzt: als Trainingsumgebung in Rechercheschulungen und als niedrigschwelliger Rechercheassistent im Umfeld des Bibliothekskatalogs. Das System ist bewusst vor den eigentlichen Recherchewerkzeugen angesiedelt: Ausgangspunkt ist eine unscheinbare Eingabemaske (Abbildung 1).
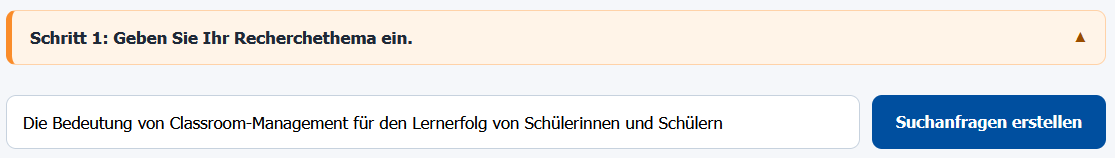
Aus der ursprünglichen, natürlichsprachigen Anfrage werden geeignete Suchbegriffe abgeleitet. Diese existieren im Hintergrund als deutsch-englische Begriffspaare; dadurch soll eine praktische Hürde internationaler Literaturrecherche möglichst früh reduziert werden: Eine in deutscher Sprache formulierte Forschungsfrage sollte nicht automatisch zu einer ausschließlich deutschsprachigen Recherche führen.
Die vorgeschlagenen Begriffe sind nicht verbindlich. Nutzende können sie per Klick auswählen, entfernen oder eigene Begriffe ergänzen. Zusätzlich können Begriffe per Klick auf die grün hinterlegte Lupe aus der Gemeinsamen Normdatei (GND) abgerufen werden (Abbildung 2).
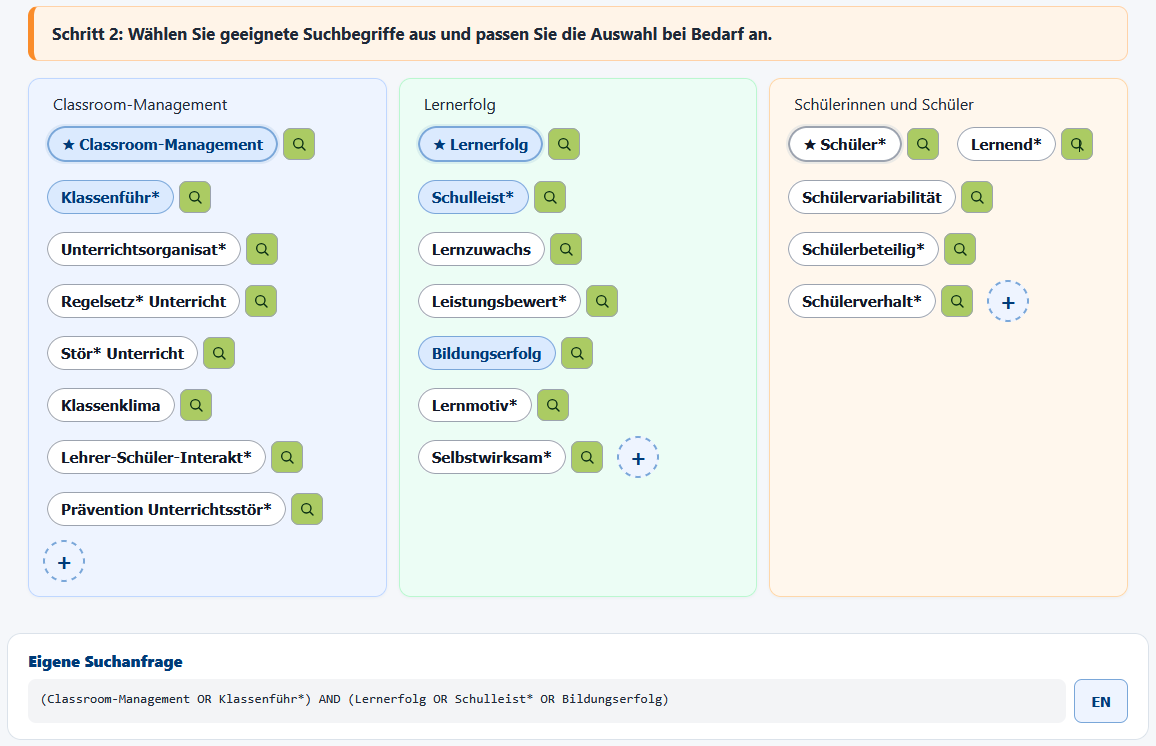
Alternativbegriffe innerhalb eines Suchkonzepts werden mit dem Booleschen Operator OR verknüpft, sodass Treffer mindestens einen dieser Begriffe enthalten können. Unterschiedliche Suchkonzepte werden mit AND kombiniert, sodass beide Konzepte in den Treffern berücksichtigt sein müssen. Die Bedienung erfolgt weitgehend durch Auswahl; die daraus entstehende Anfrage bleibt jedoch sichtbar und transparent.
Der Assistent geht damit bewusst einen Mittelweg: Die Nutzer*innen müssen nicht zuerst lernen, wie eine komplexere Suchanfrage syntaktisch aufgebaut wird. Gleichzeitig verschwindet die Syntax nicht in einer Blackbox: Die Nutzer*innen werden also weiterhin mit den zugrundeliegenden Techniken und Strategien konfrontiert.
Wer mehrere Synonyme auswählt, kann sehen, dass sie mit OR verbunden werden. Wer einen weiteren Themenaspekt ergänzt, kann sehen, dass dieser mit AND hinzugefügt wird. Wird die Anfrage durch zu viele Konzepte immer enger und droht dadurch eine sehr kleine oder leere Treffermenge, weist das System darauf hin.
Der nächste Schritt ist für das Konzept besonders wichtig. Die Bibliothek hinterlegt Profile geeigneter Rechercheangebote. Diese beschreiben unter anderem fachliche Ausrichtung, Inhalt und Zweck eines Systems. Auf Grundlage des jeweiligen Themas ordnet das Sprachmodell passende Angebote aus diesem vorgegebenen Pool zu (Abbildung 3). Damit bleibt die zentrale kuratorische Entscheidung bei der Bibliothek.
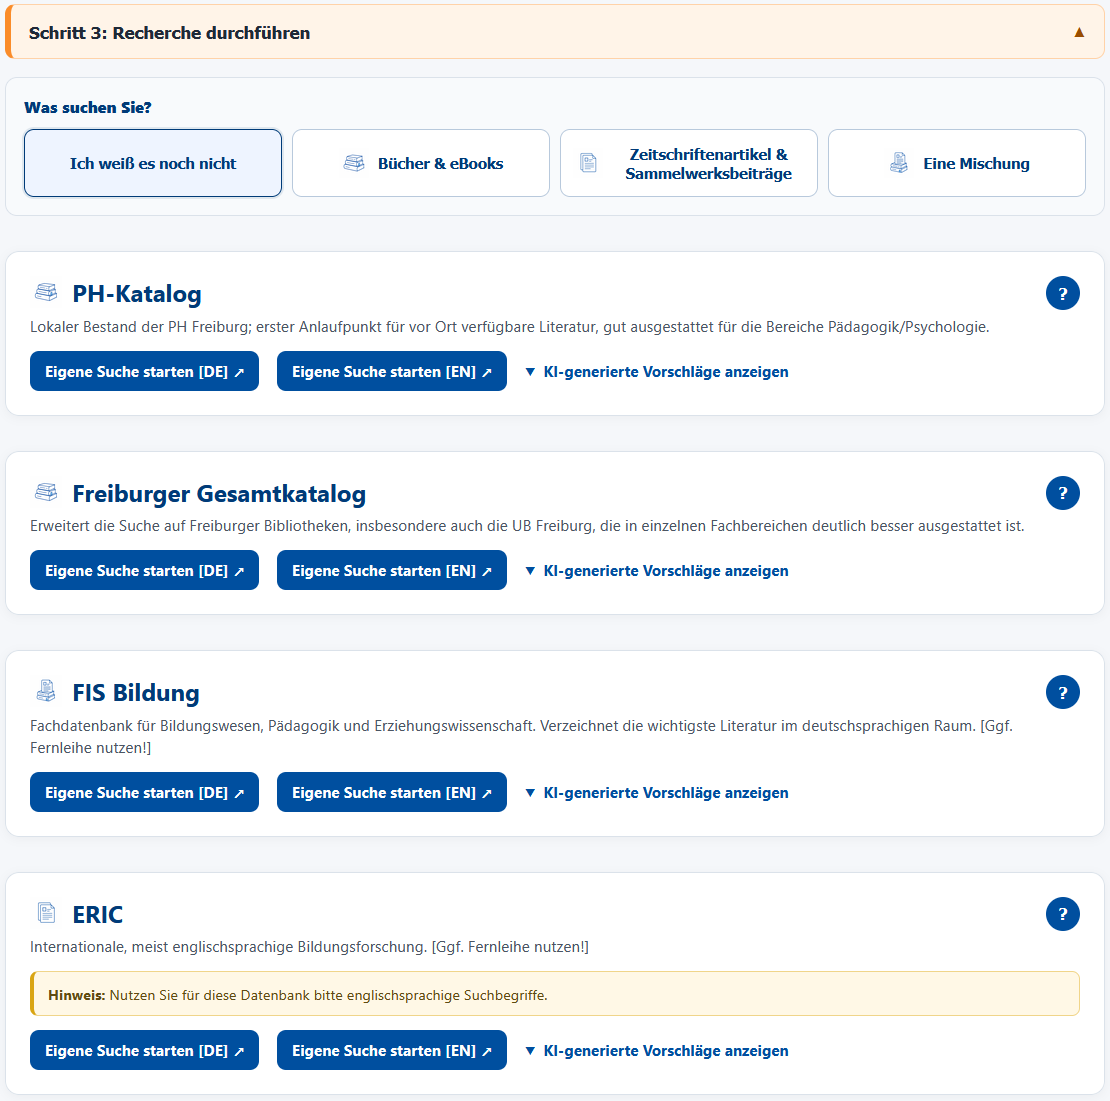
Berücksichtigt werden sowohl lizenzierte als auch fachlich geeignete frei verfügbare Informationsangebote. Nutzer*innen können die eigens formulierte Syntax anschließend per Klick direkt in den angebotenen Recherchesystemen ausführen. Ergänzt wird diese durch KI-generierte Vorschläge, die zusätzlich nach demselben Prinzip direkt ausgeführt werden können. Der eigentliche Schritt der Recherche findet damit gerade nicht im KI-Assistenten statt. Er findet im Bibliothekskatalog, in FIS Bildung, Google Scholar oder einer anderen von den insgesamt 38 hinterlegten Fachdatenbanken und Recherchesystemen statt. Der Assistent ist kein Ersatz für diese Systeme. Er ist ein Wegweiser in sie hinein. Die Sichtung und Beurteilung der Literatur ist und bleibt eine Kernkompetenz.
Bei der Entwicklung des Quellcodes wurde ChatGPT (OpenAI, verschiedene im Jahr 2026 bereitgestellte Modellversionen) unterstützend zur Codeerstellung, Überarbeitung und Fehlersuche eingesetzt. Eine vollständige Zuordnung einzelner Entwicklungsschritte zu konkreten Modellversionen ist rückwirkend nicht möglich.
Die technische Umsetzung folgt weitgehend dem Ablauf, den auch die Nutzenden sehen. Ausgangspunkt ist das eingegebene Recherchethema. Dieses wird per OpenAI-API an ein Sprachmodell übergeben und dort zunächst in mehrere inhaltliche Konzepte bzw. Themenfelder und dazugehörige (ggf. bereits trunkierte) Suchbegriffe zerlegt. Die Antwort wird in strukturierter Form an die Anwendung zurückgegeben, sodass Begriffe und Themenfelder anschließend weiterverarbeitet werden können.
Für jeden Suchbegriff wird zusätzlich eine englischsprachige Entsprechung erzeugt. Dabei wird nicht nur der einzelne Begriff übermittelt, sondern auch das ursprüngliche Recherchethema. Das Sprachmodell kann dadurch beispielsweise entscheiden, welche Übersetzung eines mehrdeutigen Begriffs im jeweiligen fachlichen Kontext sinnvoll ist. Auch später von Nutzenden ergänzte Begriffe werden auf diese Weise aufbereitet.
Parallel dazu wird eine kuratierte Liste der aus Sicht der Bibliothek wichtigsten Datenbanken zusammen mit dem Recherchethema dem Sprachmodell übergeben. Diese Liste enthält neben einer Kurzbeschreibung unter anderem Angaben dazu, für welche Publikationstypen ein System besonders geeignet ist, welche Suchmöglichkeiten bestehen und wie Suchanfragen technisch an das jeweilige System übergeben werden können. Das Sprachmodell wählt damit passende Rechercheinstrumente innerhalb eines kuratierten Angebotes und liefert diese in strukturierter Form an den Assistenten zurück.
Aus den anschließend von den Nutzenden ausgewählten Begriffen baut die Anwendung selbst ohne den Einsatz des Sprachmodells die Suchanfrage auf: Begriffe desselben Themenfeldes werden mit OR, unterschiedliche Themenfelder mit AND verbunden. Falls das jeweilige Recherchesystem dies unterstützt, wird die fertige Anfrage direkt in einen Link eingesetzt. Ergänzend können einzelne Suchbegriffe über eine Schnittstelle mit der Gemeinsamen Normdatei (GND) abgeglichen und dort gefundene Schlagwörter in die Suche übernommen werden.
Für die KI-basierten Verarbeitungsschritte nutzt die Anwendung die von der Hochschule bereitgestellte OpenAI-API. Zum Zeitpunkt der Entwicklung wurde das Modell GPT-4.1 eingesetzt. Die Verarbeitung erfolgt über den institutionellen Zugang und unter den hierfür an der Hochschule geltenden Datenschutzbedingungen. Die API-Kosten für eine vollständige Anfrage an das System liegen bei knapp unter einem Cent.
Die größte Herausforderung bei der Entwicklung des Rechercheassistenten war keine technische, sondern die ständige Entscheidung zwischen zusätzlichen Features, Hinweisen, Warnungen und dem ursprünglich intendierten niederschwelligen Zugang: Rechtfertigt das Feature den Zuwachs an Komplexität? Bei nahezu jeder Funktion gibt es einen guten Grund für einen zusätzlichen Hinweis.
Warum sind englische Begriffe wichtig?
Was bedeutet „*“ (Trunkierung)?
Was ist eine Fachdatenbank?
Was ist der Unterschied zwischen Katalog und Datenbank?
Woher weiß ich, ob ein gefundener Artikel in der Bibliothek verfügbar ist?
Jeder einzelne Hinweis lässt sich rechtfertigen, zusammen ergeben sie jedoch wieder genau das System, das eigentlich vermieden werden sollte: eine Oberfläche, die Hemmungen erzeugt, überfordert, die zunächst erklärt werden muss.
Die erste Version des Rechercheassistenten war ausdrücklich ein Prototyp. Nutzende konnten das System mit bis zu fünf Sternen bewerten. Bis zur vorläufigen Deaktivierung dieser Funktion wurden 92 Bewertungen abgegeben; der Mittelwert lag bei 4,85 von fünf Sternen. Diese Zahl ist erfreulich, aber methodisch nur sehr eingeschränkt aussagekräftig. Es handelt sich nicht um eine kontrollierte Evaluation. Die Stichprobe ist selbstselektiv, und aus einer positiven Bewertung lässt sich insbesondere nicht ableiten, dass die Nutzung des Assistenten Recherchekompetenz verbessert. Die Kommentare und mündlichen Rückmeldungen von Studierenden gehen jedoch eindeutig in eine Richtung: Der Assistent wird als hilfreich wahrgenommen; wiederholt wurde bedauert, dass ein solches Angebot nicht bereits früher im Studium zur Verfügung stand. Aufgrund dieser positiven Rückmeldungen wurde der Assistent zügig auch über den Bibliothekskatalog und die Bibliothekswebseite zur Verfügung gestellt.
Wenn technische Systeme einen Teil der Übersetzung, der Suchsyntax und zunehmend auch der Bedienung einzelner Datenbanken übernehmen können, stellt sich für bibliothekarische Schulungen die Frage: Wofür soll die knappe gemeinsame Zeit mit Studierenden verwendet werden?
Gute Erfahrungen wurden bisher damit gemacht, die verschiedenen Recherchestrategien kurz, aber nachvollziehbar zu erklären: Was macht Trunkierung? Was bewirkt eine Phrasensuche? Wie verändern Boolesche Operatoren die Treffermenge? Ein grundlegendes Verständnis der Konzepte steht dabei im Vordergrund. Darauf folgt eine Übungsphase mit dem Rechercheassistenten. Die gezeigten Strategien können so unmittelbar erprobt und angewendet werden. Dieses Vorgehen wurde bisher von den Studierenden gut angenommen und entlastet die Schulungsinhalte, da mehrere vorbereitende Übungen entfallen und die theoretischen Fundamente nicht mehr im Detail erklärt werden müssen. Die dadurch gewonnene Zeit kann für die Bestandteile wissenschaftlicher Recherche verwendet werden, die Studierenden weiterhin erhebliche Schwierigkeiten bereiten.
Was verrät mir eine Trefferliste hinsichtlich meiner Suchstrategie und wie verfeinere ich sie?
Welche Literatur würde ich wählen, und unter welchen Kriterien?
Brauche ich für meine Frage einen Aufsatz – oder zunächst eine Monografie?
Welche Perspektiven fehlen in meiner bisherigen Literaturauswahl?
Das eigentliche Ziel des KI-Rechercheassistenten ist deshalb nicht, Recherche durch KI zu ersetzen. Er soll stattdessen den Anteil der Recherche reduzieren, der lediglich aus Bedienlogik besteht. Er soll Studierende möglichst schnell an den Punkt bringen, an dem die anspruchsvollere Arbeit beginnt: Literatur finden, sichten, lesen, bewerten, auswählen, in Beziehung setzen und für die eigene Fragestellung zu verarbeiten.
Der Rechercheassistent ist weiterhin weniger als fertige Lösung denn als Experiment zu verstehen. Er versucht, zwei Entwicklungen miteinander zu verbinden: die niedrige Zugangsschwelle natürlichsprachiger Recherchesysteme und die von Bibliotheken bereitgestellten bzw. kuratierten Informationssysteme, die gerade auch wegen KI eben nicht an Bedeutung verlieren sollen. Die interessante Evaluation beginnt dabei erst noch.
Eine positive Bewertung der Oberfläche reicht nicht aus. Relevant wäre beispielsweise, ob Nutzende über den Assistenten tatsächlich häufiger Fachdatenbanken erreichen, ob sie unterschiedliche Informationsangebote besser unterscheiden können und ob die vorgeschlagenen Suchstrategien zu einer breiteren oder qualitativ besseren Literaturauswahl führen. Auch Nutzungsstatistiken einzelner Zielsysteme können Hinweise liefern. Besonders interessant wird sein, ob Angebote der Bibliothek, deren Nutzung bislang trotz fachlicher Qualität gering ist, durch einen niedrigschwelligen Zugang stärker wahrgenommen werden. Ebenso offen bleibt die Frage, welche klassischen Recherchetechniken künftig noch aktiv eingeübt werden sollten und bei welchen ein konzeptionelles Verständnis genügt, weil die technische Umsetzung zunehmend vom Informationssystem übernommen wird. Vorstellbar ist freilich auch, dass Stich- und Schlagwörter sowie Suchsyntax in einigen Jahren komplett aus den Oberflächen von Recherchesystemen verschwinden werden. In diese Diskussion sollten Bibliotheken sich bereits jetzt einbringen. Eine mögliche Antwort besteht darin, hochwertige Informationsangebote nicht hinter unnötiger Bedienkomplexität zu verstecken, sondern mit den Möglichkeiten von KI stärker in den Vordergrund zu heben.
Der Rechercheassistent der PH Freiburg setzt genau dort an: Er soll Nutzer*innen dabei unterstützen, ausgehend von einer zunächst unscharfen Fragestellung möglichst schnell geeignete Rechercheinstrumente zu erreichen und sich so einen passenden Informationsraum zu erschließen, ohne selbst zu einer Blackbox zu werden. Zugleich soll er als Werkzeug zur Vermittlung von Recherchekompetenz dienen, Berührungsängste abbauen und Studierenden einen niedrigschwelligen Einstieg in die wissenschaftliche Literaturrecherche ermöglichen.
Die Anwendung ist bewusst pragmatisch entwickelt. Eine Nachnutzung ist grundsätzlich möglich, vor einer Weitergabe wäre jedoch eine Refaktorierung des Quellcodes sinnvoll. Der Assistent ist derzeit auf den IP-Adressbereich der PH Freiburg beschränkt. Ein Testzugang kann bei Bedarf durch den Autor bereitgestellt werden.
o-bib Das offene Bibliotheksjournal
ISSN: 2363-9814